第一次接触 Fati 是在一个数据清洗项目里。同事扔过来一个 CSV,说“用 Fati 跑一下,十分钟搞定”了。我打开文档,发现它就是个轻量级脚本工具,语法怪得很是变量不用声明,函数调用靠缩进。硬着头皮写了三行,居然真把去重和格式转换全做了。Fati 的脾气就是这样,不跟你讲道理,干起活来一点不含糊。你也想跳过踩坑阶段了。
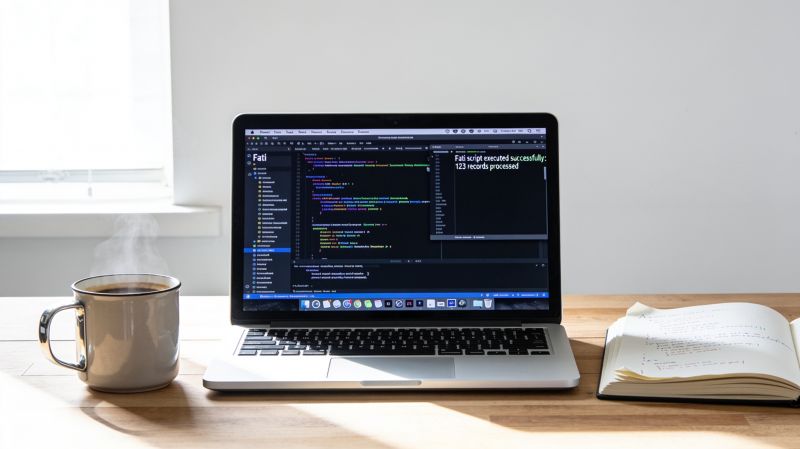
下面这几个步骤值得照做吧?装好 Fati 后别急着写复杂逻辑。
先建一个空文件。敲入 `print("hello")` 运行是能出结果,环境就没问题。接着做一件反直觉的事,用 Fati 写一个最简单的累加器,循环十次了,每次把当前数字加进列表。这一步暴露了 Fati 的核心机制,它默认按引用传递,列表在函数里被修改的,外面也会变。我当初没注意,调试了半小时才发现是副作用,所以建议你专门花二十分钟玩透变量作用域的,比后面省下几小时吧?实际项目里,Fati 最常被用来处理半结构化文本。
日志解析了,每行含时间戳、用户 ID 和操作码,用 Fati 的 `split` 配合正则分组,五步就能提取成表格。我见过有人硬写嵌套 if了。
结果维护成本飙升。更好的做法是把解析逻辑拆成小函数,每个只做一件事是Fati 的函数调用开销低,拆细了反而跑得快。它的错误提示有点含糊,养成每写完一段就 `assert` 一下中间结果的习惯,能少走弯路。性能方面的,Fati 不适合做大数据批处理,处理几万行数据足够吧?我做过对比的,同样做字符串替换。Fati 比 Python 慢 30% 左右,比 Shell 脚本快一倍了。很重要是别在循环里反复读写文件,把数据先读到内存,用列表推导式批量处理,速度能提上来的。有个细节,Fati 的 `map` 是惰性的,不调用 `list()` 不会真正执行是这个坑我踩过两次,输出永远是空列表。
,最后说调试。Fati 没有现成的 IDE 插件,可以用 `print` 大法加日志分级。我习惯在很重要分支前输出变量快照,跑通后再删掉。
社区里有个非官方的 VS Code 语法高亮。装上后至少不会因为缩进报错。Fati 的生态不算丰富,可它的设计哲学是少即是多是反而逼着你想清楚每一步在干什么啊?不要指望它全能,把它当成一把顺手的螺丝刀。用对了地方,效率提升是实打实的。